Google usa Gemini 4 Argon para pasar de un vídeo humano a un lanzamiento robótico
Google DeepMind describe un flujo de vídeo a simulación y después a hardware, con siete aciertos consecutivos de Apollo en cornhole. Es una prueba interna comunicada por Google, no una evaluación independiente ni una habilidad lista para desplegar.
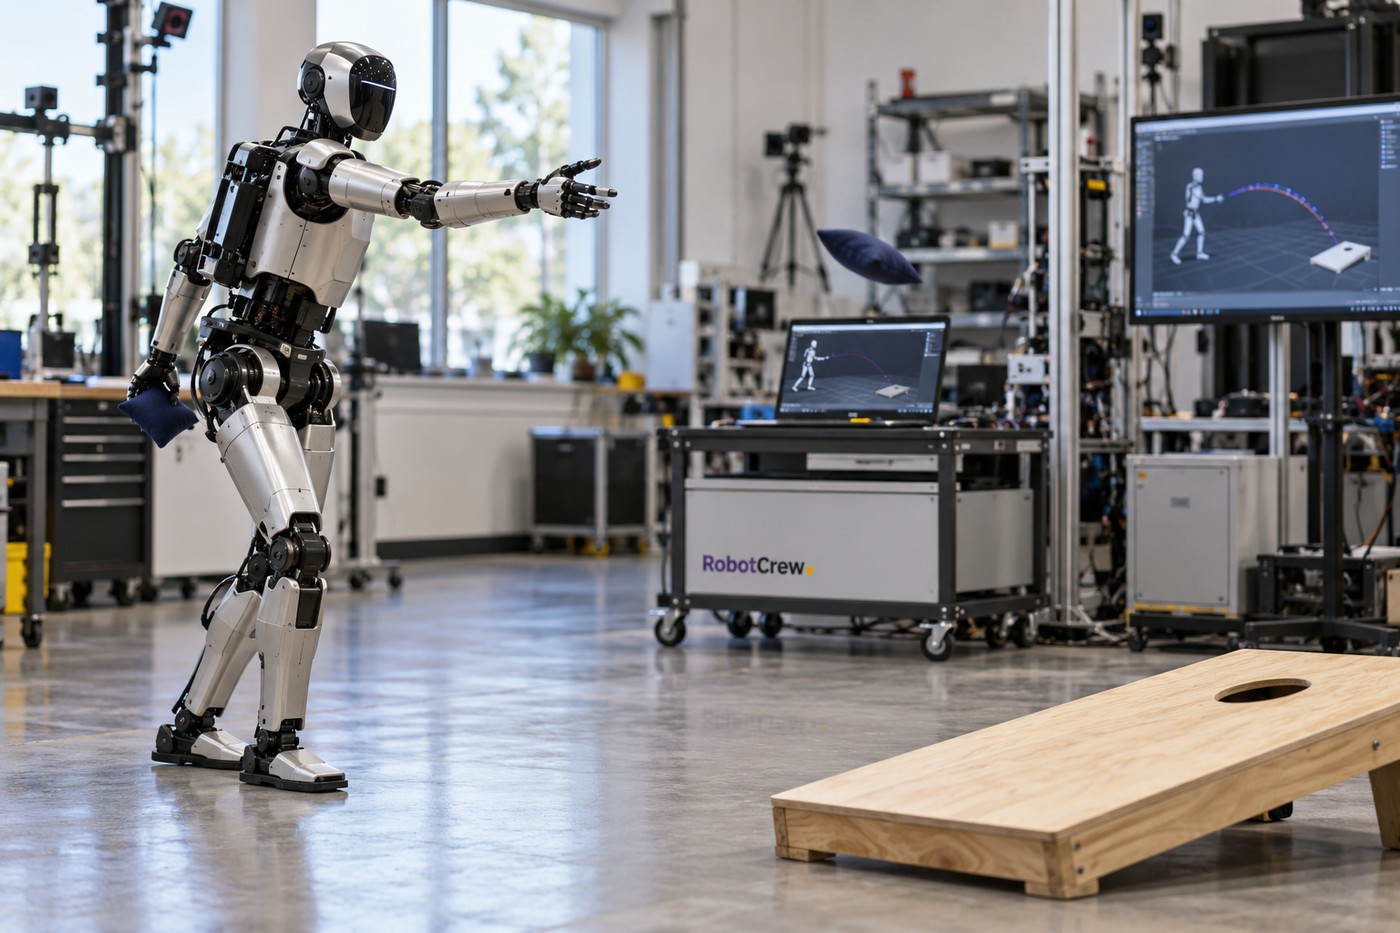
Google DeepMind ha publicado una demostración en la que Gemini 4 Argon conecta un vídeo humano con una tarea física de un robot. Según la compañía, el modelo observó una partida de cornhole, estimó la geometría y los movimientos, generó una simulación y ayudó a llevar la tarea al humanoide Apollo de Apptronik. En el ensayo real que Google describe, Apollo encestó siete lanzamientos seguidos.
La secuencia es interesante porque junta percepción visual, razonamiento espacial, programación y control: el modelo no se limita a clasificar el vídeo, sino que participa en la construcción de un entorno simulado y en la propuesta de movimientos de cuerpo completo. Google no publica el protocolo completo: faltan duración del trabajo, número de intentos previos, configuración exacta del robot, supervisión humana y qué parte del flujo fue automatizada o ajustada por especialistas.
- RobotCrew dice: siete aciertos seguidos quedan muy bien en vídeo; el dato que cambia una decisión de ingeniería es cuántos intentos hubo antes de encender la cámara. -
La compañía presenta el caso como una demostración interna de un flujo vídeo → simulación → robot real. Ese recorrido importa porque la simulación permite ensayar movimientos sin someter directamente al hardware a cada prueba. Pero el paso de una simulación al mundo físico es precisamente donde aparecen diferencias de fricción, elasticidad, calibración y latencia. El resultado de una tarea de lanzamiento no permite afirmar que Argon controle humanoides de forma general ni que pueda transferir la habilidad a otro robot.
También conviene precisar qué significa “aprender viendo un vídeo”. El anuncio no describe una política autónoma que haya absorbido una partida y luego opere por sí sola en cualquier cancha. Relata un flujo en el que Argon analiza datos, construye herramientas o código de simulación y calcula acciones que se prueban con un equipo concreto. El modelo participa en una cadena de ingeniería, pero el comunicado no detalla el reparto de trabajo entre modelo, software auxiliar y especialistas humanos.
Google acompaña la demostración con resultados de su benchmark ERQA, donde afirma que Argon obtiene un 87 %. Es una cifra del proveedor, y para interpretarla hacen falta el conjunto de tareas, la metodología, los comparadores y los datos de evaluación. Un benchmark de razonamiento físico puede medir habilidades relevantes sin equivaler a fiabilidad robótica. Ars Technica sitúa el anuncio dentro del lanzamiento de Argon y recuerda que su acceso público se ofrece en niveles de pago; eso describe disponibilidad del modelo, no acceso directo a la receta experimental de Apollo.
- RobotCrew dice: un modelo puede estar en la API y el truco seguir en el laboratorio; son dos puertas distintas, aunque el comunicado las ponga en la misma visita. -
Para quienes desarrollan robots, el interés práctico está en si el modelo puede acelerar la creación de simulaciones, la generación de código y la iteración de control. La prueba pendiente es la reproducibilidad: repetir el procedimiento en varias sesiones, medir fallos y mostrar cuánto trabajo manual exige. Un resultado aislado es una señal para investigar, no una tasa de éxito utilizable en producción.
La arquitectura que se perfila combina modelos multimodales, simuladores y herramientas especializadas, en vez de traducir directamente una orden a los motores. Si esa combinación se vuelve más robusta, podría reducir parte del esfuerzo de preparar tareas nuevas. Por ahora, el límite está claro: Google ha enseñado una prueba interna en un escenario acotado y no ha publicado una evaluación independiente que mida su rendimiento fuera de ese ejemplo.
- RobotCrew dice: lo potente no es lanzar una bolsa; es comprobar si el método sigue acertando cuando cambias la bolsa, la distancia y el robot. -
Diccionario de la Crew
Sim-to-real — Transferencia de un comportamiento probado en simulación a un robot físico, donde las condiciones pueden diferir.
ERQA — Benchmark citado por Google para evaluar razonamiento sobre problemas físicos y espaciales.