¿Qué es un modelo Vision-Language-Action (VLA)?
Modelo que conecta observaciones, instrucciones y acciones físicas.
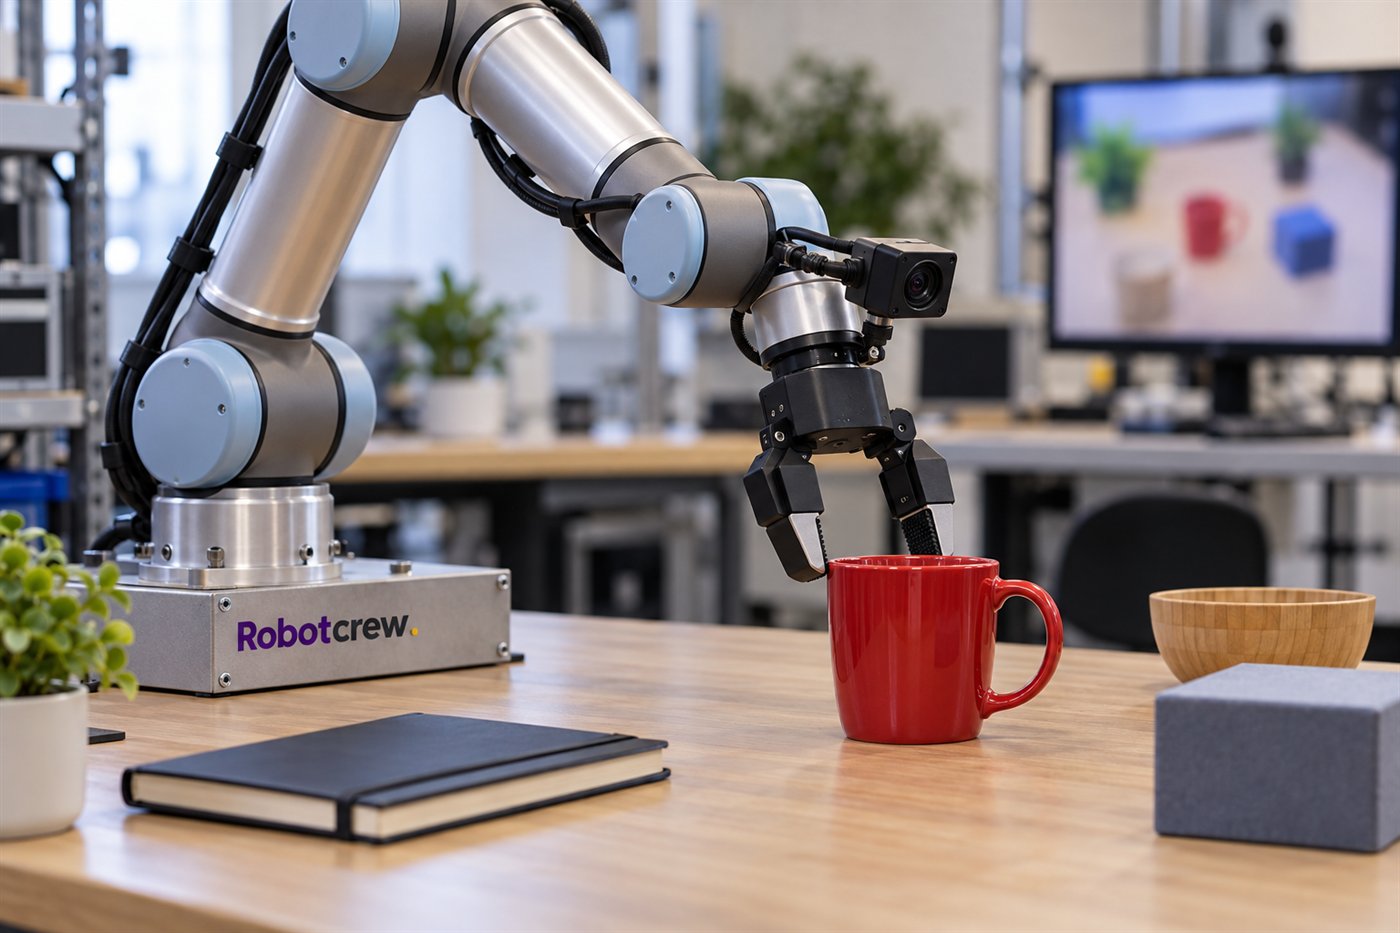
Un modelo Vision-Language-Action (VLA) conecta lo que un robot observa, la instrucción que recibe y las acciones que ejecuta. Puede recibir una imagen de una mesa y una petición como “acerca la taza roja al plato”; el modelo relaciona palabras y elementos visuales y produce una salida que el sistema robótico interpreta como movimiento. Su objetivo es unir percepción, lenguaje y acción física en una misma política.
Entender una imagen no equivale a controlar un brazo. Un modelo de visión y lenguaje convencional puede describir la escena o contestar preguntas, pero no tiene por qué saber cómo mover un brazo. Un VLA se entrena además con ejemplos de interacción robótica para asociar observaciones e instrucciones con acciones. No es simplemente un chatbot conectado a un motor: el formato de salida, los datos de entrenamiento y la integración con el robot son parte central del diseño. -RobotCrew dice: Señalar la taza con palabras es fácil; conseguir que la pinza no la convierta en percusión ya es robótica.-
De la cámara a una acción
En una tarea sencilla, una cámara aporta imágenes y la persona describe el objetivo. El modelo procesa esa información junto con el estado disponible del robot y genera una acción o una secuencia breve: por ejemplo, desplazar el efector final hacia un objeto y cerrar la pinza. La orden verbal no mueve el brazo por sí sola: el resultado debe traducirse al espacio de acciones que admite la máquina.
La forma de representar esa acción varía entre modelos. Algunos convierten valores de movimiento en tokens que la red predice junto con el resto de su salida; otros usan representaciones o secuencias distintas. En RT-2, los autores codificaron acciones robóticas como tokens de texto y combinaron esa tarea con datos de visión y lenguaje. “Action” se refiere a una salida ejecutable o interpretable por el sistema, no necesariamente a una frase en castellano.
El proceso suele repetirse mientras el robot trabaja. Una nueva imagen permite comprobar si el objeto sigue donde se esperaba, si la pinza lo ha agarrado o si alguien ha cambiado la escena. Esa realimentación puede ayudar a corregir el siguiente movimiento. Aun así, algunos sistemas ejecutan bloques de acciones antes de volver a observar; la frecuencia de revisión y la respuesta ante fallos dependen de la arquitectura. Cerrar el ciclo de percepción y acción importa tanto como generar una primera orden.
Cómo aprende la relación entre palabras y movimiento
Los VLA pueden combinar modelos preentrenados con demostraciones de robots: ejemplos de cámaras, instrucciones y movimientos realizados en tareas. RT-2 mostró una estrategia de ajuste conjunto con datos de trayectorias robóticas y tareas de visión y lenguaje. OpenVLA, por su parte, presentó un modelo abierto de 7.000 millones de parámetros entrenado con 970.000 demostraciones reales de robots. Son diseños y resultados de investigación concretos, no una garantía de que cualquier VLA vaya a resolver cualquier tarea.
La transferencia entre robots y entornos sigue teniendo límites. El aprendizaje a partir de datos variados puede ayudar a reconocer objetos nuevos o interpretar instrucciones de otra manera, pero la transferencia tiene límites. Un brazo con otra cámara, pinza, escala o espacio de trabajo puede necesitar adaptación. También influyen los ejemplos disponibles, los objetos parcialmente ocultos, las instrucciones ambiguas y las diferencias entre la mesa de entrenamiento y la real. -RobotCrew dice: “Recoge eso” parece universal hasta que el robot pregunta, con su cámara, cuál de las cuatro cosas es “eso”.-
Qué puede y qué no puede hacer
Un VLA no convierte automáticamente una demostración de laboratorio en un producto seguro. Puede elegir un objeto equivocado, producir una acción imprecisa o no reconocer que la escena ha cambiado. La velocidad de inferencia, la coordinación con los controladores del robot, los límites de movimiento y la parada ante una situación inesperada requieren atención propia. La evaluación debe hacerse en el robot y en las tareas previstas, con mecanismos adecuados para limitar acciones inseguras.
Un VLA no equivale a autonomía completa. Por eso conviene entenderlo como una pieza de una arquitectura robótica, no como sinónimo de autonomía completa. El modelo aporta una política que vincula percepción, instrucciones y acciones; sensores, actuadores, controladores, supervisión y pruebas completan el sistema. Los resultados publicados muestran avances prometedores en manipulación, pero el rendimiento depende del robot, el entorno y la tarea. -RobotCrew dice: Una frase puede ser general; la pinza, la mesa y las reglas de seguridad siguen siendo muy específicas.-
Diccionario de la Crew
VLM — Modelo que relaciona imágenes y lenguaje, sin que eso implique controlar un robot.
Política robótica — Función que convierte observaciones y objetivos en acciones.
Demostración robótica — Ejemplo registrado de una tarea realizada por un robot, usado para entrenar o evaluar modelos.