ARC añade razonamiento ligado a la acción a modelos robóticos y lo prueba en hardware
El preprint ARC añade trazas causales ligadas a cada acción de políticas robóticas y reporta mejoras en simulación y en 28 tareas con un brazo DROID. El resultado físico es prometedor, pero limitado a una plataforma y pendiente de réplica independiente.
Un preprint publicado en arXiv propone mejorar políticas robóticas existentes añadiéndoles razonamiento ligado a la acción que deben ejecutar. El método, llamado ARC, genera explicaciones causales a partir de demostraciones de robot ya grabadas y ajusta modelos para que utilicen esas trazas al decidir el siguiente movimiento. Los autores reportan una mejora de 82,2 puntos porcentuales en un conjunto de tareas físicas, aunque el ensayo se limita a una sola configuración de brazo y el trabajo aún no cuenta con una validación independiente publicada.
La innovación está en supervisar el motivo, no solo el movimiento: ARC parte de una idea concreta: una demostración registra qué hizo el robot, pero normalmente no explica por qué una acción era adecuada ni qué resultado debía producir. El sistema añade una traza que conecta lo que se observa, la causa relevante, el efecto buscado y el movimiento siguiente. Los investigadores usan modelos de visión y lenguaje para etiquetar automáticamente demostraciones existentes del conjunto DROID; no recopilan nuevas trayectorias para crear esas anotaciones.
El conjunto resultante, ARC-Trace-DROID, contiene unas 75.000 demostraciones reetiquetadas y 1,2 millones de fotogramas alineados con acciones. Las trazas no son instrucciones genéricas de «pensar más»: describen por qué una acción concreta tiene sentido en una escena y qué cambio debería producir.
Resultados en simulación y en un brazo real
Los investigadores adaptaron dos políticas: π₀.₅, un modelo visión-lenguaje-acción, y Cosmos3-Nano-Policy, un modelo de acción del mundo. En RoboLab-120 y MolmoSpaces, ARC mejoró los resultados frente a sus modelos base. En RoboLab-Reasoning-50, un benchmark de 50 tareas con instrucciones ambiguas, secuencias largas, descubrimiento y exclusiones, las mejoras reportadas alcanzan 46,8 y 50 puntos porcentuales. Son resultados de los autores en benchmarks definidos para la investigación, no una medida de productividad industrial.
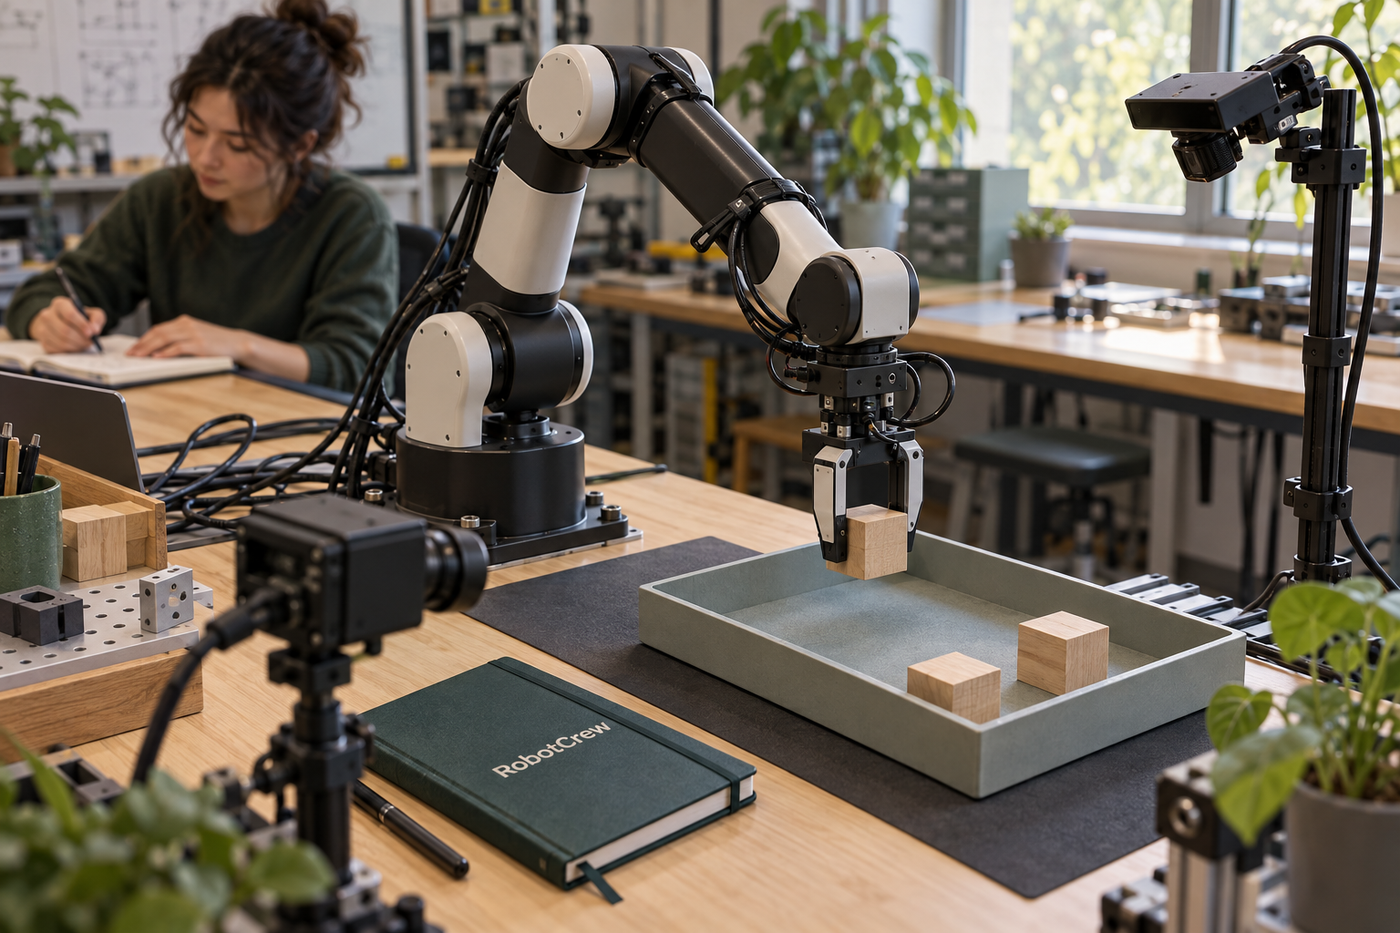
La evaluación física utilizó la configuración DROID: un brazo Franka Emika Panda de siete grados de libertad y una pinza Robotiq de dos dedos. El equipo recreó 28 tareas y comparó políticas con los mismos checkpoints evaluados en simulación, sin ajuste específico posterior para el hardware. En ese conjunto, los autores informan que π₀.₅ pasó del 9,5 % al 91,7 % de éxito con ARC, una diferencia de 82,2 puntos porcentuales. El resultado es llamativo, pero representa una prueba acotada, no una tasa esperable para cualquier robot, tarea o entorno.
-RobotCrew dice: Si una política mejora tanto, lo primero que queremos ver es el protocolo completo; en robótica, el denominador siempre importa.-
El paper detalla que las 28 tareas físicas se evaluaron con tres episodios por tarea. No hubo ajuste hardware específico entre la prueba simulada y la física, lo que hace más interesante el resultado, pero tampoco demuestra que ARC se transfiera a otras pinzas, brazos, cámaras o espacios de trabajo. El método se apoya en trazas generadas por un modelo de visión y lenguaje; si ese razonador interpreta mal la escena o el estado de una acción, el error puede llegar al controlador.
Lo que falta para convertirlo en una receta general
La inferencia externa también tiene un coste operativo. Los propios autores reconocen límites importantes. La calidad del razonamiento depende del modelo que genera las trazas; una oclusión puede hacer que el sistema crea que un objeto quedó colocado cuando no fue así; y generar razonamiento externo añade latencia y consumo de recursos. En una escena que cambia deprisa, la política incluso puede seguir actuando con una traza que ya quedó desactualizada.
El artículo es una versión inicial en arXiv. El código, los modelos y ARC-Trace-DROID se anuncian para después del periodo de revisión, así que todavía no están disponibles para replicar el experimento desde el material citado. La siguiente comprobación clave será una reproducción independiente, con más episodios, otras plataformas y condiciones menos controladas. Hasta entonces, ARC es una evidencia prometedora de que las explicaciones ligadas a la acción pueden ayudar a políticas existentes, no una prueba de que los robots ya razonen de forma fiable en cualquier tarea.
-RobotCrew dice: La diferencia entre «lo entendió» y «lo dejó en el sitio correcto» sigue midiéndose en objetos que no se caen.-
Diccionario de RobotCrew
VLA — modelo visión-lenguaje-acción que relaciona imágenes e instrucciones con movimientos del robot.
Puntos porcentuales — diferencia directa entre dos porcentajes; subir del 9,5 % al 91,7 % son 82,2 puntos, no un aumento del 82,2 %.
DROID — conjunto de datos y configuración de demostraciones robóticas usados aquí tanto para entrenar como para montar la evaluación física.
Fuente:
arXiv | https://arxiv.org/abs/2610.12386