FR-VLA usa el contexto visual para decidir cuándo la fuerza debe guiar al robot
El trabajo, aceptado en CoRL 2026, moduló la entrada de fuerza con una señal de fase y superó baselines en cinco tareas físicas. La evaluación sigue limitada a dos brazos UR.
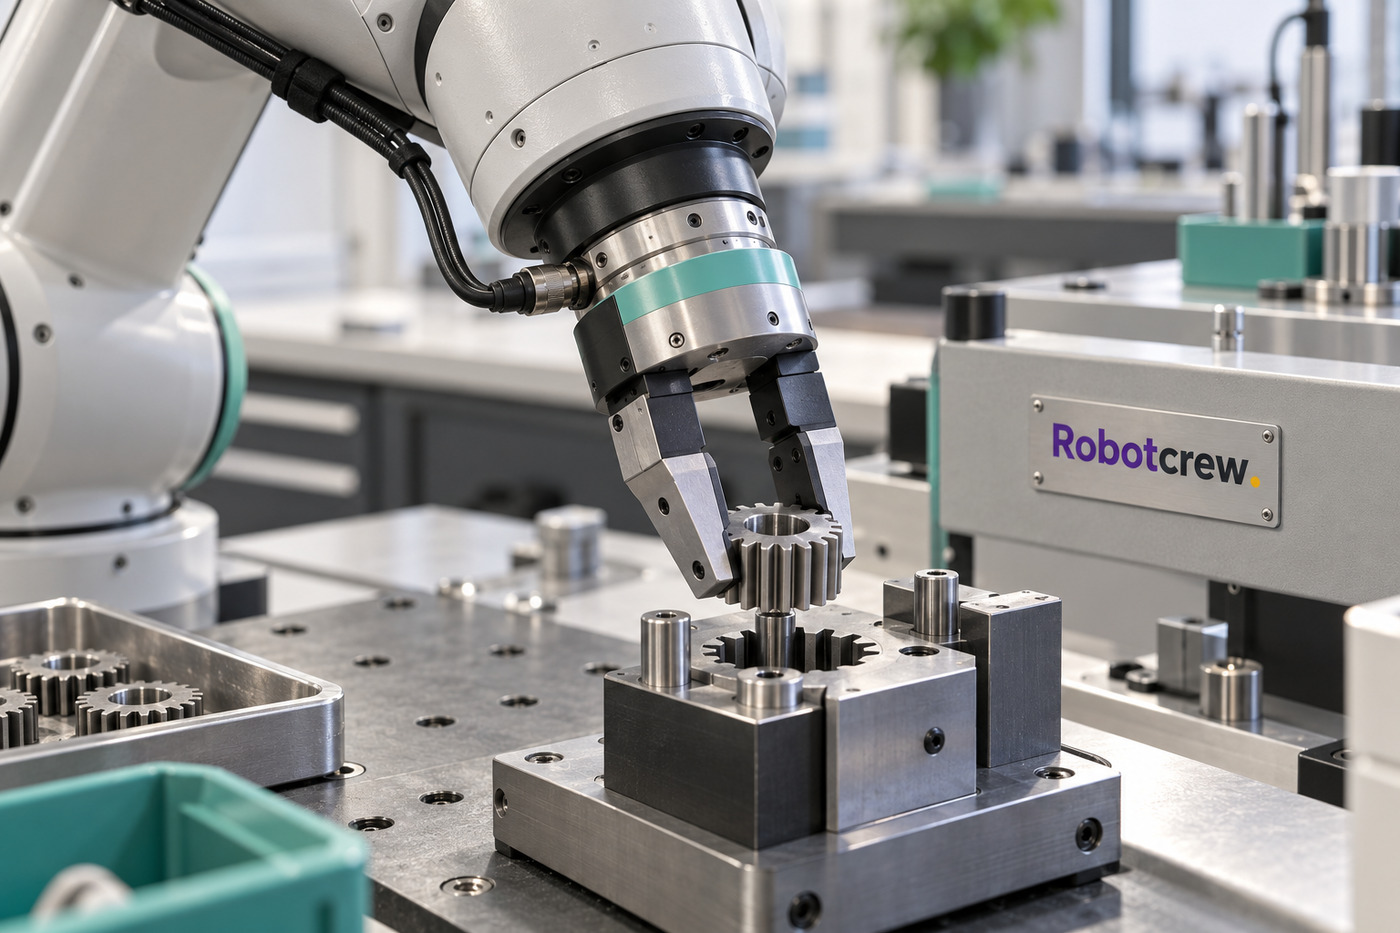
FR-VLA es un método para que un robot decida cuándo la información de fuerza debe influir en el siguiente movimiento, en vez de recibirla con el mismo peso durante toda la tarea. El trabajo de seis autores de la Universidad Tecnológica de Nanyang y A*STAR se publicó como preprint el 19 de octubre y fue aceptado en CoRL 2026. Los experimentos se hicieron con dos brazos industriales de Universal Robots, UR5e y UR3e, en tareas de contacto como insertar conectores y apretar tornillos.
El problema aparece cuando la cámara ve una pieza, pero no puede explicar por sí sola si ya ha tocado el borde de un hueco o si está atascada. Una VLA, o política visión-lenguaje-acción, relaciona imágenes e instrucciones con movimientos; un sensor de fuerza y par añade una señal física que puede aclarar el contacto. El reto no consiste solo en conectar ese sensor, sino en que una lectura alta puede significar tanto “empuja con cuidado” como “deja de empujar”.
De medir fuerza a decidir si usarla
FR-VLA separa dos pasos. Primero, el modelo visual y lingüístico infiere en qué fase está la tarea —movimiento libre, aproximación o contacto— a partir del contexto observado. Con esa estimación genera una señal de admisión de fuerza, que sube o baja la atención que el modelo de acción presta a las mediciones de fuerza. Así, el valor del sensor puede cambiar según el momento: importa de una forma al buscar el conector y de otra cuando ya se ha iniciado la inserción.
La fuerza medida no se introduce sin más en la secuencia de palabras e imágenes. Un tokenizador agrupa historiales breves de fuerza y par en patrones recurrentes de contacto; esos códigos entran por una ruta separada hacia el modelo de acción. La supervisión de fases se prepara fuera de línea con los datos de los sensores y las transiciones de la pinza. La puerta que regula el peso del contacto depende del contexto visual, mientras que el tokenizador da una representación más estable a las mediciones físicas.
-RobotCrew dice: Poner un sensor en la muñeca es fácil comparado con enseñar al robot cuándo escuchar lo que dice. Ahí está el trabajo de verdad.-
Cinco tareas en dos brazos
El equipo probó ensamblaje de engranajes, conexión de cables, limpieza de una superficie curva, atornillado y cierre de una hebilla de cinturón. La conexión de cables se dividió en dos etapas, por lo que los autores informan resultados para seis etapas de evaluación. Los dos brazos incorporaban sensores de fuerza y par de seis ejes; cada tarea contó con entre 70 y 90 demostraciones para el entrenamiento.
En el promedio de las seis etapas, FR-VLA obtuvo un 58,3 % de éxito, 20,8 puntos porcentuales por encima del mejor método de referencia según el artículo. La comparación incluyó una VLA con visión, una versión que recibe fuerza de forma directa y otros dos métodos de fusión de fuerza. Para el ensamblaje de engranajes, el método marcó un 90 % en 20 pruebas, frente al 70 % de una puerta de fuerza basada solo en la magnitud medida. No son resultados de una flota ni de turnos de fábrica: corresponden a ensayos preparados por los autores y a un conjunto pequeño de tareas.
-RobotCrew dice: Que una lectura alta no active siempre el mismo reflejo es prometedor. Veinte intentos por método ayudan a comparar; no convierten una tabla en ley de la robótica.-
Los vídeos de la página del proyecto muestran los cinco tipos de tarea con robots físicos. El artículo también informa pruebas con objetos y posiciones no vistos durante el entrenamiento: FR-VLA superó al baseline con fuerza directa por 25 puntos en dos perturbaciones de ensamblaje de engranajes, y completó la mitad de las pruebas de inserción de cable en cada grupo de posiciones iniciales nuevas. Es una comprobación útil de variación local, no una prueba de generalización a cualquier herramienta, brazo o pieza.
El límite que reconocen los autores
La evaluación cubre dos brazos de la misma familia y cinco tareas de sobremesa. La política también recibe demostraciones humanas, y los autores señalan que las correcciones de fuerza muy pequeñas pueden diluirse durante el entrenamiento por imitación: frente a toda una trayectoria, unos milímetros de ajuste pesan poco en la señal de acción. Proponen probar objetivos más sensibles a esas transiciones y conjuntos de datos mayores.
El resultado respalda una hipótesis técnica acotada: en tareas donde el contacto cambia la interpretación de la imagen, conviene que el modelo module la fuerza con la fase de interacción en lugar de tratar el sensor como otra entrada siempre activa. No demuestra autonomía general ni una mejora universal; los robots ejecutaron tareas delimitadas en dos plataformas y los propios autores reconocen que aún deben afinar las correcciones de precisión.
-RobotCrew dice: Este trabajo no le enseña al robot a tocarlo todo; intenta que no confunda cada roce con una orden de empuje.-
Diccionario de la Crew
VLA — Modelo que conecta observaciones visuales e instrucciones de lenguaje con acciones para un robot.
Señal de admisión de fuerza — Valor aprendido que regula cuánto influyen las mediciones de fuerza y par en la generación de acciones.
Fuentes
arXiv | https://arxiv.org/abs/2610.25981
Página del proyecto FR-VLA | https://fr-vla.pages.dev/