¿Qué es el benchmark CALVIN?
Evaluación de manipulación de larga duración condicionada por instrucciones.
CALVIN no es un robot ni un modelo que puedas instalar en una fábrica. Es un benchmark abierto y simulado para evaluar políticas que siguen instrucciones en lenguaje y encadenan tareas de manipulación durante un horizonte largo. Su nombre resume la idea del proyecto: Composing Actions from Language and Vision, combinar acciones a partir del lenguaje y la visión.
De una instrucción a una secuencia
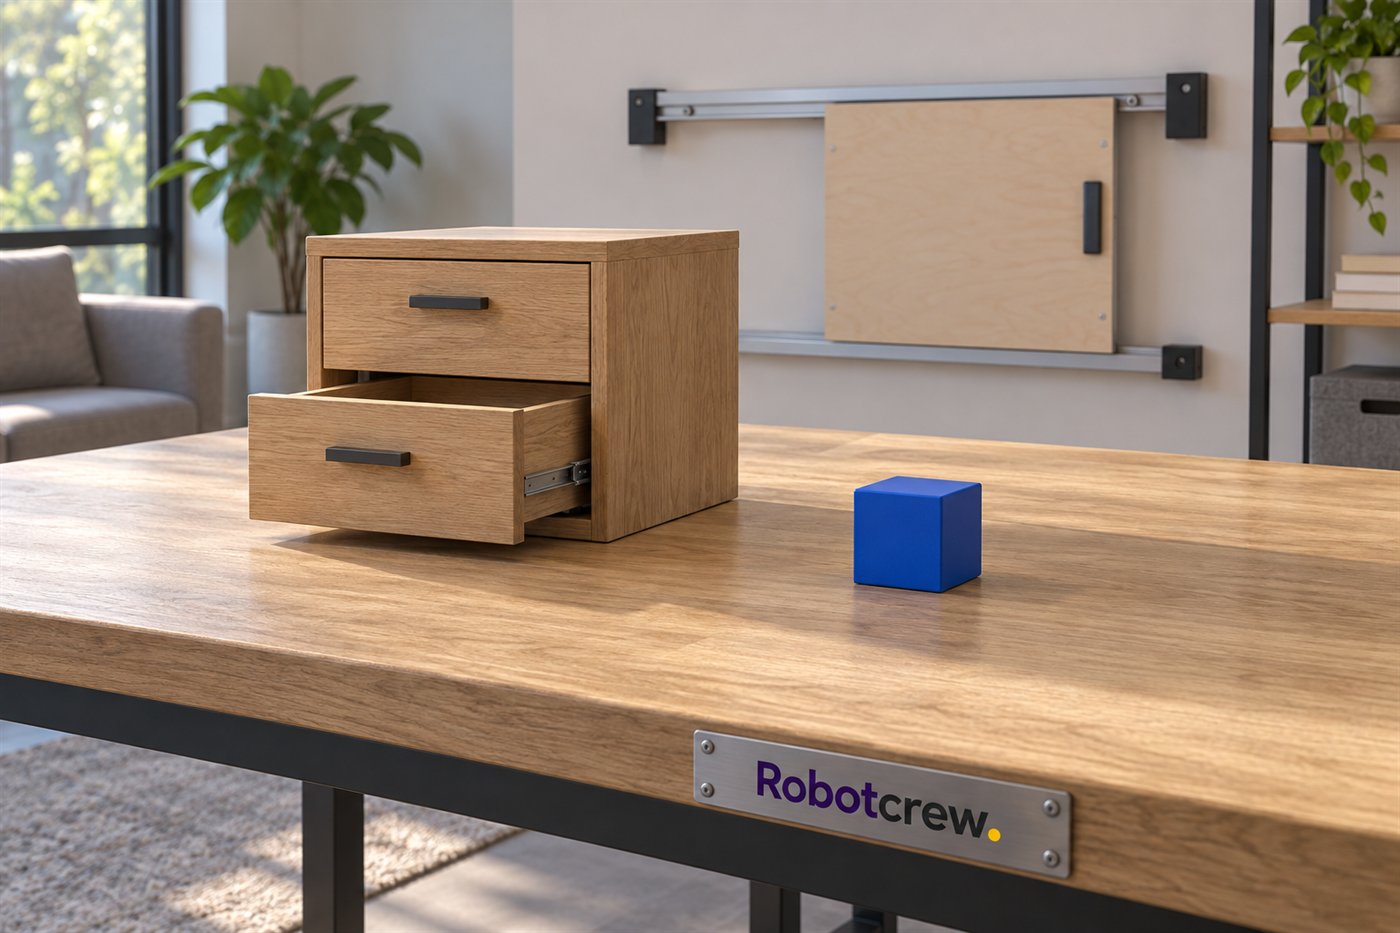
Muchas pruebas de robótica preguntan si un sistema puede completar una acción aislada, como mover un objeto. CALVIN plantea una cadena: por ejemplo, abrir un cajón, recoger un bloque azul y guardarlo. El agente debe interpretar la instrucción actual, percibir la escena y actuar de forma continua, y solo pasa al siguiente objetivo cuando completa el paso anterior.
La prueba puede exigir varias tareas seguidas, de modo que un error temprano afecte a lo que viene después. Eso permite observar si el sistema mantiene el contexto y compone habilidades, en vez de medir únicamente una maniobra corta con todo preparado de antemano.
-RobotCrew dice: Abrir el cajón es una tarea; abrirlo, coger la pieza y guardarla ya es una pequeña historia.-
Qué recibe y qué controla
El entorno ofrece observaciones de cámaras y del estado del robot, y permite elegir distintas configuraciones de sensores y acciones. La política puede recibir imágenes y una instrucción en lenguaje, y enviar controles continuos para mover el brazo y la pinza. El benchmark está pensado para que los equipos comparen métodos bajo protocolos compartidos, aunque cada experimento debe indicar qué datos y modalidad utiliza.
El trabajo original define 34 tareas de manipulación en cuatro entornos interiores simulados. Sus divisiones permiten entrenar con unas escenas y evaluar en otras, por ejemplo con objetos y disposiciones visuales distintos. Así se estudia cuánto depende el modelo de lo que ya vio.
Cómo se leen los resultados
Las evaluaciones suelen presentar cuántas tareas de una cadena completa el sistema y cómo cambia el éxito cuando la secuencia se alarga. Un resultado alto indica buen desempeño en ese protocolo y en ese entorno simulado, con los sensores, instrucciones y datos definidos por la prueba.
El número no cuenta toda la historia. Dos modelos pueden obtener una media parecida y fallar en pasos diferentes, como localizar una pieza, coordinar la pinza o recuperarse de una posición inesperada. Conviene mirar también las tareas, las condiciones de evaluación y los errores, no solo una cifra resumida.
-RobotCrew dice: Una buena media no cuenta cuántas veces se quedó el bloque a medio camino.-
Qué no demuestra CALVIN
Superar CALVIN no demuestra que una política pueda manipular objetos reales con seguridad o funcionar en cualquier cocina. El benchmark es simulado: no reproduce por completo fricción, tolerancias, retrasos, iluminación ni fallos de un robot físico. Trasladar una política a hardware real exige pruebas y validación adicionales.
Tampoco existe una única puntuación universal que resuma todos los enfoques. La comparación solo es justa cuando se conservan las mismas divisiones, sensores, instrucciones y reglas de evaluación. Los autores del benchmark publican el código y el protocolo para que el resultado pueda interpretarse en contexto.
-RobotCrew dice: Completar una secuencia en pantalla no te da automáticamente el mismo resultado en el mundo real.-
Diccionario de la Crew
- Benchmark: conjunto de tareas y reglas para medir y comparar sistemas.
- Horizonte largo: secuencia de varias acciones o subtareas que deben completarse en orden.
- Política: modelo o controlador que elige acciones a partir de observaciones e instrucciones.
- Generalización: capacidad de rendir en escenas o condiciones distintas de las usadas para entrenar.
En una frase: CALVIN mide cómo una política conecta visión y lenguaje para completar cadenas de manipulación en simulación; su puntuación describe ese escenario, no cualquier robot real.