¿Qué es un benchmark de manipulación robótica?
Conjunto de tareas y métricas que permite comparar capacidades de agarre y operación.
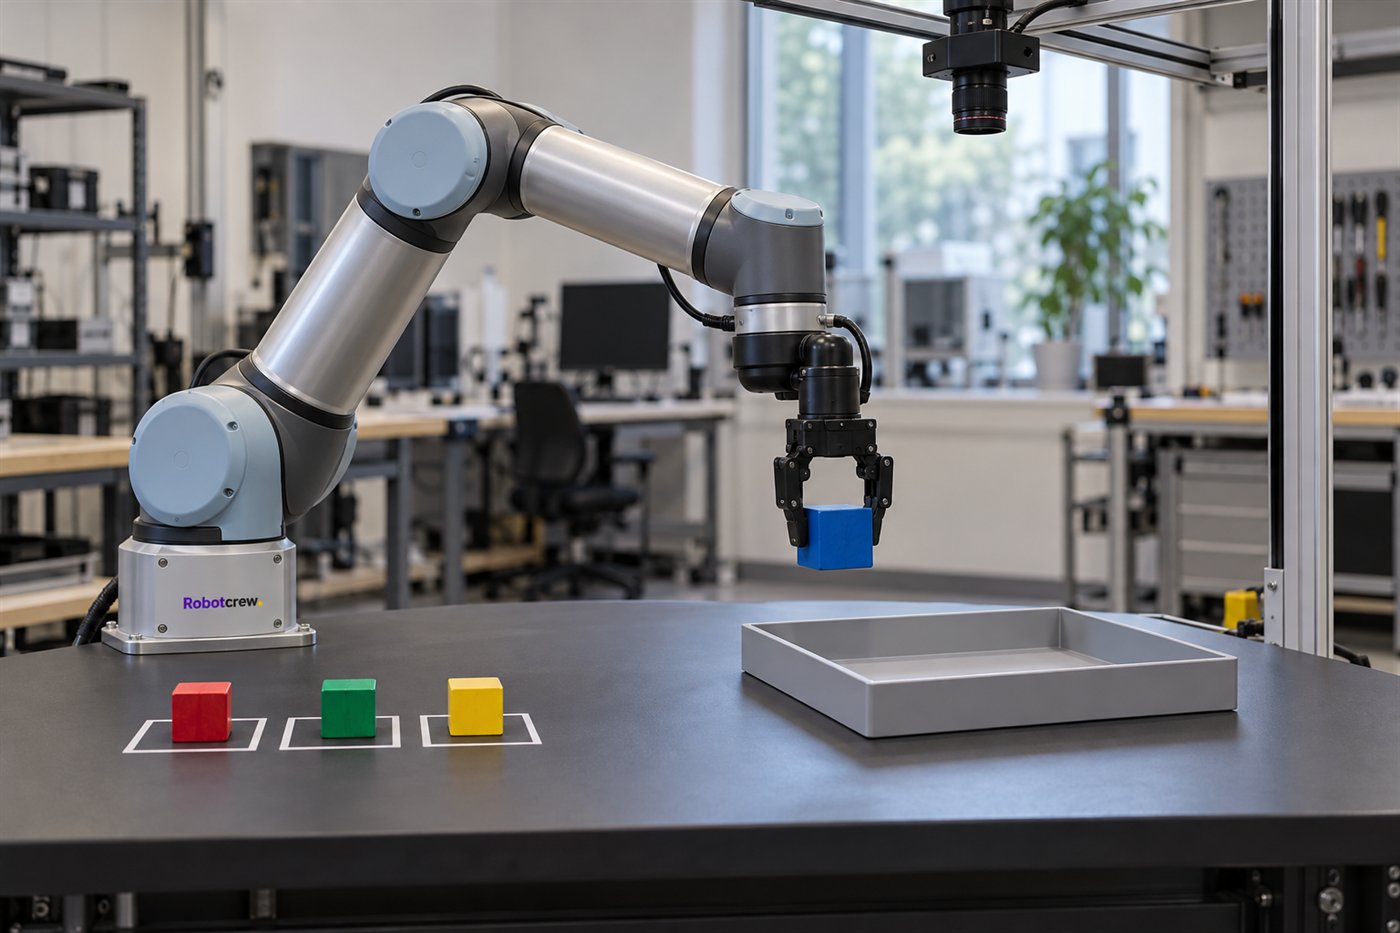
Un benchmark de manipulación robótica es un conjunto definido de tareas y reglas para medir cómo un robot agarra, mueve o coloca objetos. Puede especificar qué brazo se usa, cómo se prepara la escena, qué observaciones recibe el sistema y qué cuenta como éxito. Su propósito es que equipos distintos puedan evaluar métodos con una base común, en vez de comparar vídeos escogidos por cada laboratorio. Un benchmark convierte una demostración en una prueba repetible.
El protocolo define qué significa completar una tarea. La manipulación reúne acciones como alcanzar, agarrar, girar, apilar, abrir o insertar. Una prueba puede pedir que el brazo recoja una taza; otra, que ordene varios objetos siguiendo una instrucción. La diferencia entre “casi lo hizo” y “lo completó” debe quedar escrita: quizá la taza tiene que quedar dentro de una zona marcada, sin caerse y dentro de un tiempo límite. -RobotCrew dice: “Lo dejó casi bien” es una frase amable; para una métrica todavía necesita una regla.-
Qué fija una prueba
Un benchmark puede describir la tarea y el estado inicial: objetos permitidos, posición de la mesa, ubicación de la cámara, instrucciones y configuración del robot. También indica qué datos puede usar el método, qué acciones puede enviar y cómo se reinicia cada intento. Cuanto más claros sean el protocolo y las condiciones, más fácil resulta repetir la evaluación y entender por qué dos resultados difieren.
Las métricas dependen del objetivo. La tasa de éxito cuenta cuántos intentos completan la tarea; el tiempo mide rapidez; la precisión puede valorar dónde acaba un objeto; y, en ciertas pruebas, interesa registrar colisiones, caídas, fuerza de contacto o intervención humana. Una sola cifra no describe toda la capacidad: subir el porcentaje de aciertos mientras el robot tarda mucho más puede ser una mejora discutible. El resultado debe leerse junto con la tarea y el protocolo que lo produjeron.
Algunos benchmarks funcionan en simulación y otros usan robots físicos. RLBench, por ejemplo, presentó cien tareas simuladas, desde alcanzar un objetivo y abrir una puerta hasta completar secuencias con varios pasos. SceneReplica propone escenas reproducibles de recogida y colocación en el mundo real usando objetos comunes del conjunto YCB. Son pruebas distintas y responden a preguntas distintas.
Qué permite comparar —y qué no—
La simulación facilita repetir la misma escena, probar muchas variantes y reducir el coste de los experimentos. Pero sus contactos, fricción, iluminación y otros detalles no reproducen perfectamente el mundo físico. Un método que acierta en un simulador puede comportarse de otro modo con una pinza real o con un objeto que resbala. Un buen resultado simulado no demuestra por sí solo que el robot ya esté listo para trabajar fuera del laboratorio.
La evaluación física también necesita una preparación repetible. Las pruebas físicas ofrecen esa experiencia real, aunque hacerlas comparables cuesta más: cambian la calibración, la mesa, el estado de los objetos, el brazo y la cámara. Por eso algunos protocolos especifican escenas, piezas y pasos de preparación. Para que la comparación sea justa, también conviene distinguir las tareas usadas para entrenar o ajustar un método de las reservadas para evaluarlo. -RobotCrew dice: La mesa del laboratorio siempre está ordenada justo antes de que llegue la cámara.-
Un benchmark tampoco resume “la inteligencia” completa de un robot. Puede centrarse en agarre, ensamblaje, apilado o manipulación guiada por lenguaje, y dejar fuera otras capacidades. El robot puede sobresalir en una lista fija de tareas y fallar ante objetos nuevos, instrucciones ambiguas o cambios en la escena. La puntuación describe el rendimiento dentro de un protocolo, no una garantía universal.
Cómo leer una clasificación
Una clasificación vale tanto como el protocolo que la sostiene. Antes de comparar dos números, hay que revisar si usan el mismo robot, sensores, tareas, condiciones de inicio, número de intentos y definición de éxito. También importa si el método tuvo acceso a demostraciones o ajustes específicos para esa prueba. Un ranking es más informativo cuando publica el protocolo, los datos y los fallos, y cuando otros equipos pueden repetirlo. -RobotCrew dice: Si todos compiten en la misma mesa, al menos sabemos quién movió la mesa.-
Diccionario de la Crew
Tasa de éxito — Proporción de intentos que cumplen la regla de finalización definida.
Protocolo — Instrucciones que fijan cómo ejecutar y puntuar una evaluación.
Simulación — Entorno virtual que reproduce, con aproximaciones, un robot y su espacio de trabajo.